
Claude Membuktikan 239 Jalur Kode Tak Crash—Tapi Bukan Seluruh Library
Anthropic melaporkan Claude membuat bukti formal untuk 239 titik masuk di 123 pustaka open-source. Hasilnya menarik karena bukan sekadar tes berulang: bukti diperiksa mesin. Tapi cakupannya juga spesifik—hanya binary dan kondisi tertentu, bukan seluruh kode di setiap library.
Foto kode ilustrasi, bukan tampilan proyek Anthropic atau Theorem. Foto oleh Markus Spiske, digunakan sesuai Unsplash License.
Fuzz test diubah menjadi target pembuktian
Riset yang diterbitkan Anthropic pada 22 Oktober ini dikerjakan bersama Theorem, perusahaan yang membuat perangkat untuk verifikasi formal. Mereka mengambil target uji dari OSS-Fuzz, proyek Google yang menjalankan banyak input acak ke kode open-source untuk mencari kondisi yang membuat program gagal.
Kali ini, tim tidak hanya menambah jumlah input. Target fuzzing dikompilasi menjadi binary RISC-V, lalu spesifikasinya dirumuskan sebagai: untuk semua input di bawah 64 MB yang termasuk dalam model, program tidak mengalami error memori, assertion gagal, atau crash. Claude menulis buktinya dalam Rocq; kernel Rocq—bagian yang memeriksa bukti—kemudian mengecek apakah hasilnya memenuhi spesifikasi.
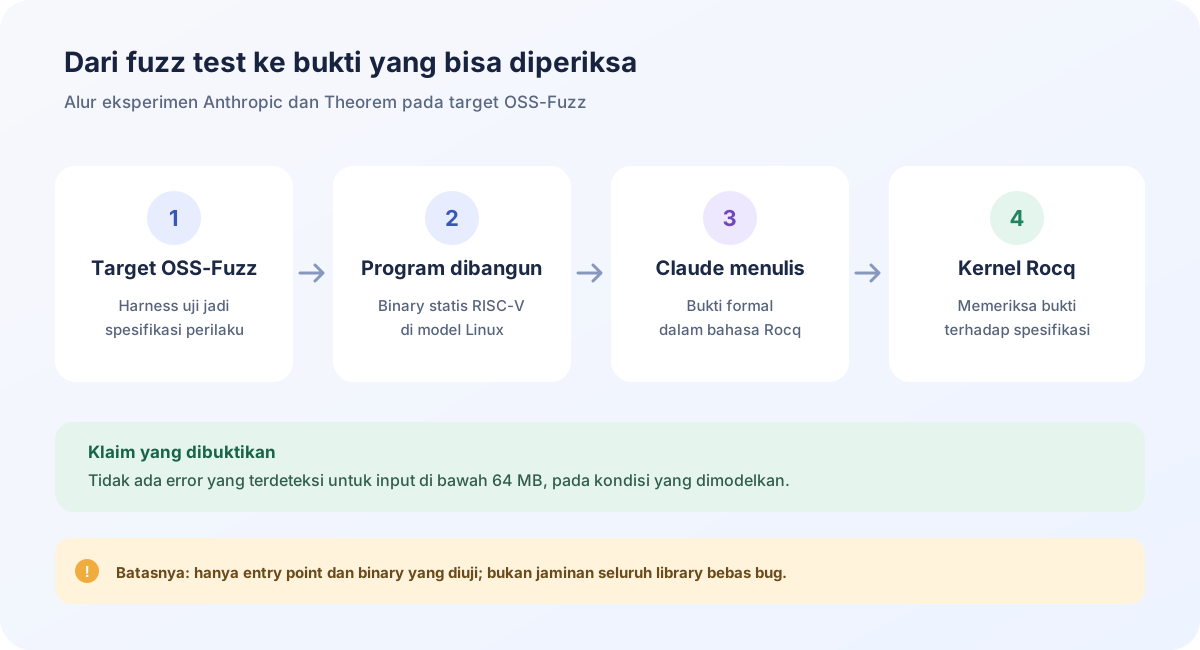
Alur diringkas dari penjelasan teknis Anthropic.
Skalanya tidak kecil: kumpulan bukti yang dilaporkan mencapai sekitar 180 juta baris Rocq. Itu bukan 180 juta baris source code library, melainkan bukti matematika yang dihasilkan untuk diperiksa mesin.
Apa yang berhasil dibuktikan—dan apa yang belum
Anthropic menyebut Claude menyelesaikan bukti untuk 239 entry point dari 123 pustaka dalam beberapa pekan. Di repositori bukti yang dibuka Theorem, pembaca saat ini bisa memeriksa subset berisi 60 entry point dari 25 pustaka.
Kata “dibuktikan” perlu dibaca sesuai batas eksperimennya. Binary yang diuji adalah program statis satu thread untuk RISC-V dan Linux, dengan batas memori tertentu. Bukti tidak mencakup semua fungsi dalam satu library, tidak otomatis berlaku pada build x86 atau ARM yang dipakai kebanyakan tim, dan hanya memeriksa jenis error yang masuk ke spesifikasi serta model tersebut. Hasilnya juga tidak menjamin program selalu selesai.
Dengan kata lain, “formal verification” di sini memberi jaminan yang lebih kuat daripada menguji sampel input, tetapi hanya untuk pertanyaan yang didefinisikan dengan tepat. Rocq memeriksa bukti matematika yang ditulis Claude; ia tidak memastikan bahwa spesifikasi dan model mesin sudah mencakup semua perilaku dunia nyata.
Bukan cuma membuktikan, Claude juga menemukan bug
Anthropic mengatakan proses pembuktian membantu menemukan bug yang belum tertangkap sebelumnya. Salah satunya adalah penemuan kembali CVE-2026-56132 di libexpat, sementara bug lain mencakup akses di luar batas memori. Klaim ini berasal dari laporan tim Anthropic; hasilnya belum menjadi evaluasi independen atas seluruh pustaka yang diuji.
Yang membuat kabar ini menarik bagi developer bukan klaim bahwa AI sudah bisa “menjamin kode aman”. Tim masih harus memilih sifat apa yang ingin dibuktikan, membangun model yang cocok, lalu memastikan binary yang dipakai memang sama dengan yang diverifikasi. Namun pekerjaan yang dulu membutuhkan keahlian khusus dan waktu panjang mulai bisa dikerjakan dalam skala lebih besar, lalu dicek oleh proof checker.
Diskusi Hacker News tentang riset ini meraih 215 poin dan hampir 120 komentar saat diperiksa pada 23 Oktober. Pertanyaan yang paling penting untuk proyek semacam ini sekarang bukan hanya berapa banyak bukti yang bisa ditulis Claude, tetapi seberapa dekat model CPU, sistem operasi, dan binary tersebut dengan perangkat lunak yang benar-benar dikirim ke pengguna.
Anda akan diarahkan ke sumber asli artikel ini.


