
DeepSeek Buka Kode Mesin Inferensi, tetapi Rilisnya Belum Lengkap untuk Layanan Online
DeepSeek membuka kode DeepInfer, framework inferensi yang menurut perusahaan dipakai untuk menjalankan layanan berskala besar. Rilis Apache 2.0 ini baru mendukung DeepSeek-V4.1-Flash dan inferensi offline. Untuk melayani banyak pengguna lewat API, beberapa bagian penting seperti sistem cache dan load balancing belum disertakan.
Foto ilustrasi, bukan fasilitas milik DeepSeek. Foto: Kevin Ache/Unsplash, digunakan sesuai Unsplash License.
Yang dibuka DeepSeek
Inferensi adalah tahap ketika model yang sudah dilatih menerima permintaan lalu menghasilkan jawaban. Framework seperti DeepInfer mengatur cara komputasi itu dijalankan: dari kernel yang digunakan sampai pembagian pekerjaan ke banyak akselerator. Pilihan di lapisan ini berpengaruh pada kecepatan dan biaya layanan.
DeepSeek menyebut DeepInfer sebagai framework yang menopang layanan produksinya. README GitHub merinci mesin inferensi offline, optimasi kernel, pemrosesan paralel, dan format keluaran terstruktur. Perusahaan juga mengatakan framework ini awalnya dibangun terutama di atas vLLM, dengan inspirasi dari SGLang dan TensorRT-LLM.
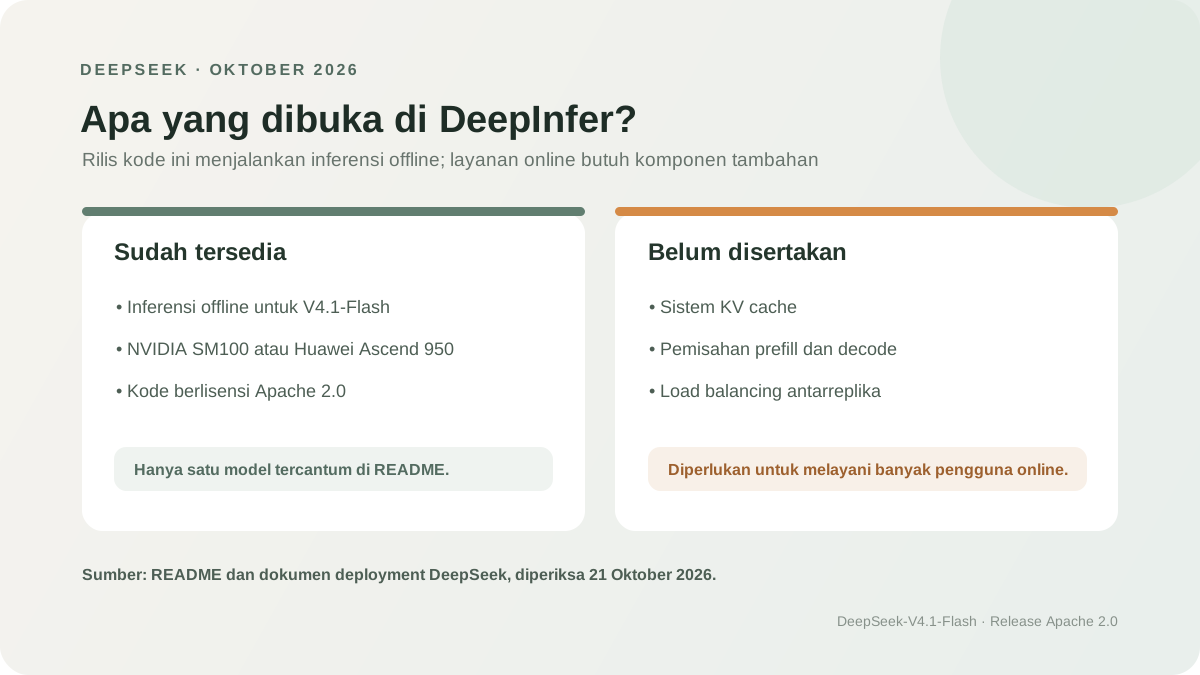
Ringkasan cakupan rilis berdasarkan README DeepInfer dan dokumen tanya jawab deployment.
Bukan paket siap pasang untuk API publik
README DeepInfer hanya mencantumkan DeepSeek-V4.1-Flash sebagai model yang didukung, serta akselerator NVIDIA SM100 dan Huawei Ascend 950. Untuk layanan online lengkap, repo itu menyebut sistem KV cache, pemisahan tahap prefill dan decode, serta load balancing antarreplika belum disertakan. DeepSeek menjelaskan dalam dokumen deployment bahwa sebagian komponen layanan produksinya masih terikat pada infrastruktur internal.
Persyaratan perangkatnya juga tinggi: proyek ini meminta Linux, Python 3.12, dan CUDA 13 untuk NVIDIA atau CANN 9.2 untuk Ascend. Snapshot model V4.1-Flash-1017 di Hugging Face berukuran sekitar 510 GB. Lisensinya pun terpisah: kode DeepInfer memakai Apache 2.0, sementara bobot modelnya memakai MIT.
Kenapa developer memperhatikannya
Repo ini memberi developer kesempatan mempelajari cara DeepSeek mengatur inferensi skala besar. Saat diperiksa pada 21 Oktober, repo tersebut sudah mengumpulkan lebih dari 12.000 stars, sementara thread di r/LocalLLaMA mencatat 764 upvotes. Komentator membahas perbandingan dengan vLLM dan SGLang serta meminta dukungan untuk GPU yang lebih umum. Angka itu menunjukkan minat komunitas, bukan bukti performa.
Namun, angka kecepatan yang dibagikan DeepSeek belum diuji secara independen, menurut The Next Web. Jadi, untuk saat ini nilai praktisnya paling jelas bagi tim yang memiliki akselerator yang didukung dan ingin mempelajari implementasinya. Seberapa jauh ia bisa menekan biaya atau mempercepat layanan baru akan terlihat setelah pengujian di luar DeepSeek dan dukungan komponen layanan online bertambah.
Anda akan diarahkan ke sumber asli artikel ini.


