
Liquid AI Luncurkan RIPL untuk Respons Cepat, Aksesnya Masih Khusus Enterprise
Liquid AI merilis RIPL, mesin inferensi untuk fitur yang tak bisa menunggu beberapa detik—misalnya pencarian produk atau pemeriksaan transaksi. Perusahaan menyebut sebagian pengujian menghasilkan jawaban dalam kurang dari 50 ms. Angka itu masih berasal dari benchmark Liquid sendiri, sementara RIPL baru ditawarkan lewat deployment enterprise.
Foto ilustrasi, bukan fasilitas Liquid AI. Foto oleh Taylor Vick di Unsplash, digunakan sesuai Unsplash License.
RIPL adalah singkatan dari Real-time Inference Pipeline. Liquid AI merancangnya untuk membawa model generatif ke alur seperti pemeringkatan hasil dan pemeriksaan risiko pembayaran—tugas yang sering memakai model klasifikasi lebih ringan karena harus menjawab cepat. Pengumuman RIPL terbit pada 22 Oktober.
Angka cepatnya datang dari skenario tertentu
Pada beban pendek—32 token masuk dan 32 token keluar, dengan 1.000 permintaan per detik—LFM2.5-1.2B lewat RIPL mencatat latensi p95 34,6 ms. Qwen3.5-0.8B lewat vLLM mencatat 498 ms. P95 berarti 95 persen permintaan dalam pengujian itu selesai dalam waktu tersebut.
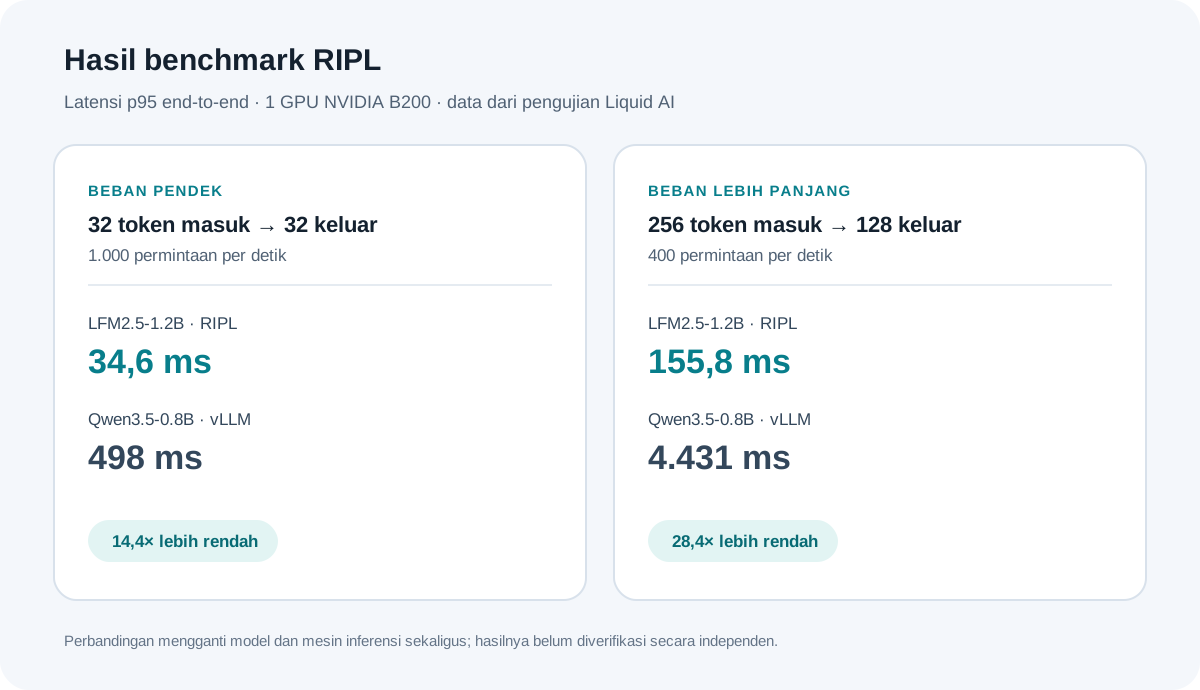
Angka berasal dari pengujian Liquid AI pada satu GPU NVIDIA B200. Perbandingan mengganti model dan mesin inferensi sekaligus, dan belum menjadi benchmark independen. Rincian skenario dilaporkan MarkTechPost berdasarkan pengumuman Liquid AI.
Pada skenario yang lebih panjang—256 token masuk dan 128 token keluar, dengan laju 400 permintaan per detik—latensi p95 LFM di RIPL naik menjadi 155,8 ms. Jadi, angka di bawah 50 ms berlaku pada bentuk permintaan tertentu, bukan jaminan untuk semua model dan panjang konteks.
Selisih 14,4 kali itu juga tidak mengukur RIPL saja: model Liquid dipasangkan dengan RIPL, sedangkan Qwen dijalankan di vLLM. MarkTechPost mencatat Liquid turut menguji model LFM yang sama di dua mesin, tetapi hasil yang tersedia tetap berasal dari pengujian perusahaan.
Belum jadi paket yang bisa dipasang bebas
RIPL tersedia untuk deployment enterprise di GPU NVIDIA H100, H200, B200, dan RTX PRO 6000. Liquid mengarahkan calon pengguna untuk menghubungi timnya; MarkTechPost menyebut engine ini belum terbuka untuk umum. Liquid juga menyebut Shopify memakai LFM pada pencarian produksi dengan inferensi di bawah 20 ms. Klaim penggunaan dan hasil itu berasal dari Liquid AI.
Di thread r/machinelearningnews, seorang komentator mengingatkan bahwa model klasifikasi biasa mungkin lebih masuk akal untuk tugas pendek. Itu pendapat, bukan hasil pengujian, tetapi pertanyaannya penting: apakah fitur memang membutuhkan kemampuan generatif, atau cukup dengan model yang lebih sederhana?
RIPL bisa masuk daftar uji bagi tim yang butuh model generatif dengan respons cepat dan bersedia memakai deployment enterprise. Sebelum mengandalkan angka benchmark, ukur latensi dan kualitas jawaban pada bentuk permintaan serta trafik yang benar-benar dipakai produk sendiri.
Anda akan diarahkan ke sumber asli artikel ini.


