Model AI GoTo 27 Miliar Parameter Dukung Bahasa Daerah, tapi Butuh GPU Besar
GoTo merilis model AI 27 miliar parameter yang kartu modelnya mencantumkan enam bahasa: Indonesia, Inggris, Jawa, Sunda, Batak Toba, dan Bali. Bobotnya sudah tersedia di Hugging Face, tetapi menjalankan model dalam presisi penuh perlu sekitar 54–60 GB memori GPU. Jadi, ini lebih realistis untuk tim yang punya akses ke server GPU atau layanan cloud daripada laptop biasa.
Model bernama GoTo-AI-Gemma-3-27B-IT itu diumumkan di Bali Tech Week pada 19 Oktober. GoTo mengembangkannya bersama AI Singapore dengan basis arsitektur Gemma 3. Kartu model menyebut konteks hingga 128 ribu token dan menyediakan contoh menjalankannya lewat Transformers maupun vLLM. TechNode Global melaporkan peluncurannya, sementara rincian teknisnya tercantum di kartu model resmi GoTo.
Foto ilustrasi oleh Matheus de Souza di Pexels. Foto ini tidak menggambarkan tim GoTo atau acara Bali Tech Week; digunakan sesuai lisensi Pexels.
Fokusnya pada bahasa yang sering luput
Kartu model mencantumkan enam bahasa: Inggris, Indonesia, Jawa, Sunda, Batak Toba, dan Bali. GoTo juga menyebut sejumlah uji yang dipakai untuk mengevaluasi model, termasuk IndoMMLU dan SEA-HELM. Daftar itu memberi gambaran tentang jenis kemampuan yang mereka ukur, tetapi belum menjawab seberapa baik model menangani dialek, istilah pekerjaan, atau gaya bahasa di aplikasi tertentu.
Untuk developer, bobot terbuka memberi ruang untuk mencoba model di alur kerja sendiri: misalnya merangkum dokumen berbahasa Indonesia atau membuat purwarupa layanan yang perlu memahami bahasa daerah. Hasilnya tetap perlu diperiksa dengan contoh nyata dan penutur bahasa terkait, terutama sebelum dipakai untuk keputusan penting. GoTo sendiri mengingatkan bahwa model dapat menghasilkan jawaban keliru atau mengarang informasi.
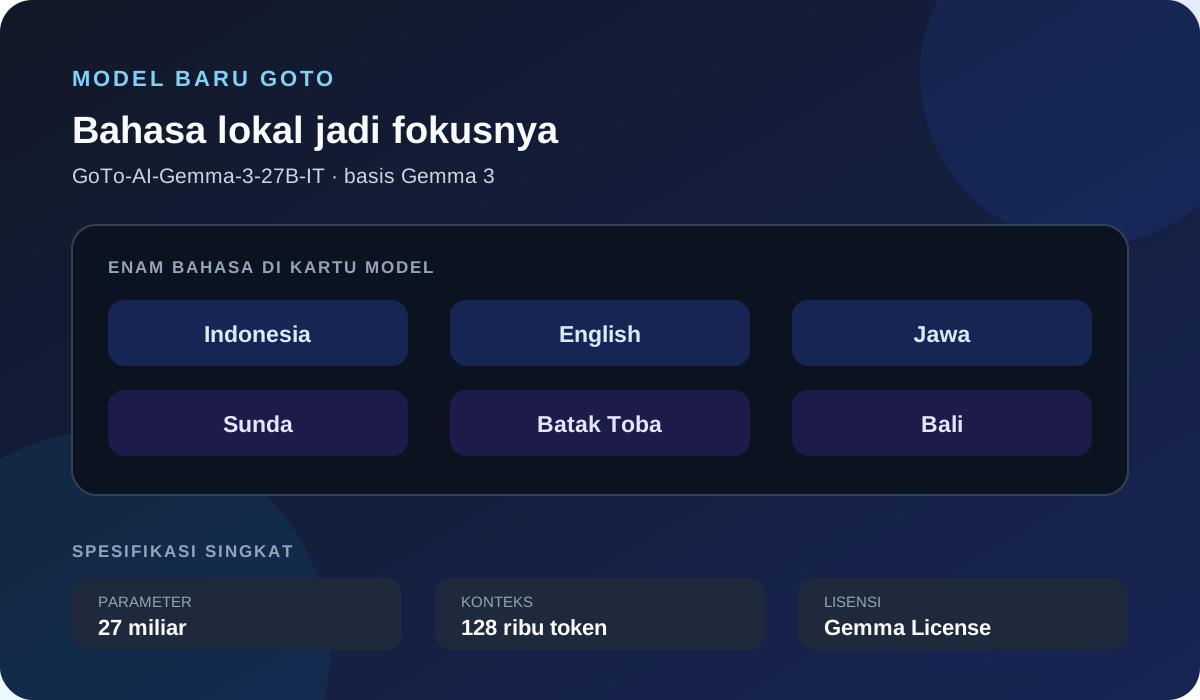
Ringkasan berdasarkan kartu model GoTo. Daftar bahasa ini bukan peringkat akurasi.
Bobot bisa diunduh; lisensinya tetap perlu dibaca
GoTo menyebut model ini open-source, tetapi kartu Hugging Face mencantumkan Gemma License dari Google. Itu berbeda dari lisensi permisif seperti MIT atau Apache-2.0. Tim yang ingin mengubah, membagikan, atau memakai model dalam produk sebaiknya membaca ketentuan Gemma dan memastikan penggunaannya sesuai.
Ada pula ongkos komputasi. Menurut kartu model, versi FP16 atau BF16 memerlukan sekitar 54–60 GB VRAM; GoTo menyarankan konfigurasi seperti satu NVIDIA A100 80 GB atau beberapa GPU lain. Angka itu khusus untuk dua format tersebut, jadi tim yang mempertimbangkan model ini tetap perlu menghitung kebutuhan GPU untuk konfigurasi yang akan mereka pakai.
Rilis ini memberi developer Indonesia pilihan baru untuk bereksperimen dengan bahasa lokal tanpa melatih model dari nol. Langkah berikutnya bukan sekadar mengunduh bobotnya: tim perlu mengukur kualitas pada data mereka sendiri, mengecek lisensi, lalu menghitung biaya server sebelum menentukan apakah model ini cocok untuk produk.
Anda akan diarahkan ke sumber asli artikel ini.