
NVIDIA Perluas Agent Toolkit dengan Model Kumo dan Nemotron Retriever
NVIDIA memperluas Agent Toolkit agar agen AI bisa mencari informasi di dokumen perusahaan, membaca pola pada data bisnis, lalu bekerja dengan batas akses yang ditentukan tim. Pengumuman di GTC Berlin pada 21 Oktober ini menyatukan model pencarian Nemotron Retriever, keluarga model data terstruktur Kumo, dan runtime OpenShell.
Foto ilustrasi, bukan fasilitas NVIDIA. Foto oleh Kevin Ache melalui Unsplash, digunakan sesuai Lisensi Unsplash.
Dokumen dan tabel ditangani dengan model berbeda
Agent Knowledge Foundation menjadi lapisan data dalam toolkit tersebut. NVIDIA menyertakan library CUDA-X seperti cuDF dan cuGraph, serta Auto-Ontology—library Python yang memetakan istilah bisnis, misalnya pelanggan, produk, dan pesanan, ke hubungan di data perusahaan.
Untuk pencarian dokumen, Nemotron Retriever menyediakan model embedding, reranking, dan parsing dokumen. Sementara itu, Kumo menangani data tabular, relasional, dan deret waktu: developer bisa memakainya untuk memprediksi permintaan, mendeteksi anomali, atau memberi skor risiko. Menurut dokumentasi Kumo, modelnya dapat dipakai langsung atau disesuaikan dengan data sendiri.
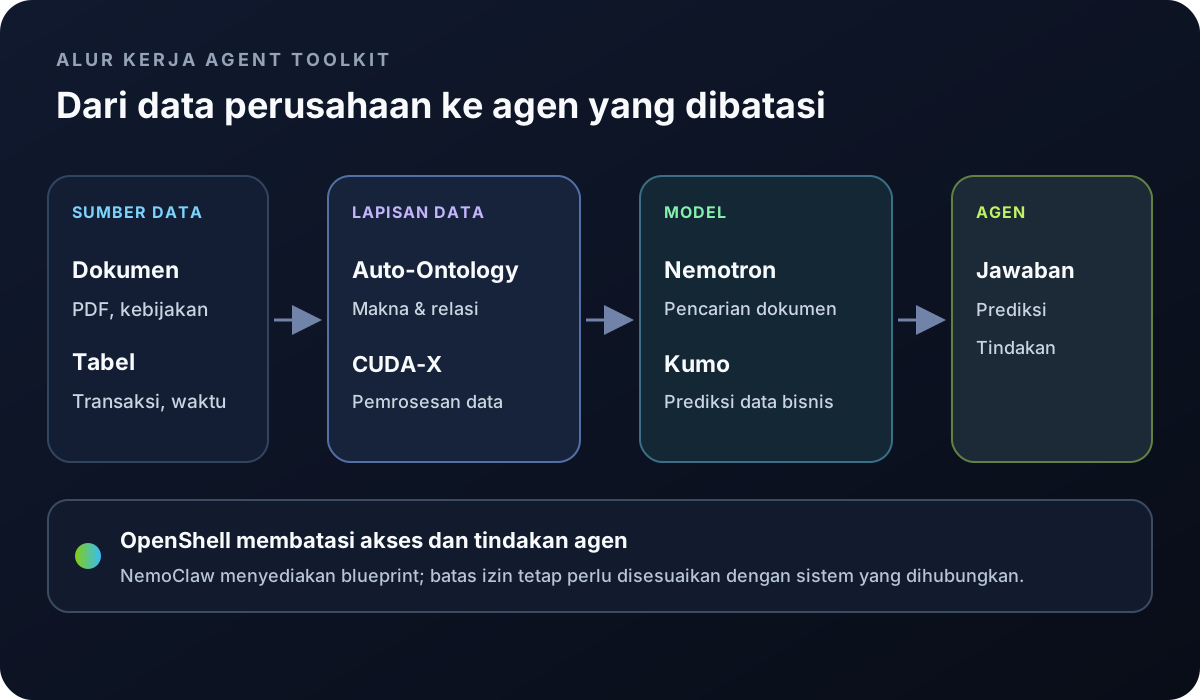
Diagram konseptual berdasarkan pengumuman NVIDIA; komponen pada toolkit dapat dipakai terpisah.
Runtime mengatur apa yang boleh dilakukan agen
Menemukan jawaban yang tepat belum cukup kalau agen juga punya akses untuk mengubah data atau memanggil tool. NVIDIA menempatkan OpenShell sebagai runtime yang membatasi akses dan tindakan agen. NemoClaw menyediakan blueprint sebagai titik awal untuk membangun agen khusus dengan pengaturan keamanan.
Jadi, toolkit ini bukan satu model baru yang otomatis menyelesaikan pekerjaan. Isinya beberapa lapisan yang perlu dipilih dan dirangkai: menghubungkan data, memberi konteks bisnis, mencari atau menghitung jawaban, lalu mengatur izin agen saat bertindak.
Sebagian komponennya sudah bisa dicoba
NVIDIA mencantumkan sejumlah organisasi yang memakai bagian dari toolkit, termasuk Databricks dengan Kumo Anomaly dan Snowflake dengan Kumo Engine. Perusahaan juga menyebut peningkatan relevansi pencarian di Amazon OpenSearch serta reranking SAP yang berjalan hampir tiga kali lebih cepat. Angka tersebut berasal dari contoh yang disampaikan NVIDIA, bukan perbandingan independen.
Developer bisa mulai dari repo Auto-Ontology, yang memakai lisensi Apache 2.0, atau memasang pustaka Kumo lewat pip install kumo-engine. Model Kumo dan Nemotron Retriever tersedia melalui kanal yang dicantumkan NVIDIA, termasuk Hugging Face. Ketersediaan dan lisensi tetap perlu diperiksa per komponen; istilah “Agent Toolkit” tidak berarti semua bagiannya datang sebagai satu paket instalasi.
Langkah NVIDIA ini menunjukkan fokus yang makin luas dari menyediakan model: perusahaan juga ingin menyediakan lapisan data, pencarian, prediksi, dan kontrol untuk agen. Bagi tim yang sedang membuat agent perusahaan, pertanyaan praktisnya adalah apakah Kumo dan Retriever cocok dengan data yang sudah ada—serta seberapa ketat batas OpenShell dapat disesuaikan dengan izin yang dibutuhkan.
Anda akan diarahkan ke sumber asli artikel ini.


