
OpenAI Tambah Cache Prompt 12 Jam; Biaya Tulisnya 2x Opsi 30 Menit
Agent yang dipanggil beberapa kali sehari biasanya mengirim ulang instruksi, daftar tool, dan konteks yang sama. Mulai 20 Oktober, developer yang memakai Responses API bisa meminta cache prompt itu bertahan minimal 12 jam. Ada ongkosnya: tarif saat menulis cache menjadi dua kali opsi bawaan 30 menit.
Foto ilustrasi, bukan pusat data milik OpenAI. Foto oleh panumas nikhomkhai di Pexels, digunakan sesuai lisensi Pexels.
OpenAI mencatat pilihan baru 12h di changelog API. Cache prompt menyimpan bagian awal request yang berulang—misalnya instruksi sistem dan definisi tool—agar pemanggilan berikutnya tidak selalu menagih bagian itu sebagai input biasa.
Tarif baca tetap rendah, tarif tulisnya yang naik
Untuk model GPT-5.6 dan yang lebih baru, menulis cache dengan masa bawaan 30 menit dikenai 1,25 kali tarif input biasa. Pilihan 12 jam menaikkan tarif tulis menjadi 2,5 kali. Setelah tersimpan, tarif membaca ulang cache tetap 0,1 kali tarif input pada kebanyakan model tersebut; GPT-6.1 Sol memakai 0,05 kali. Jadi, ongkos awalnya lebih tinggi, sementara penghematan baru terasa jika prefix yang sama benar-benar dipakai lagi. Rincian tarif dan perilakunya ada di panduan OpenAI.
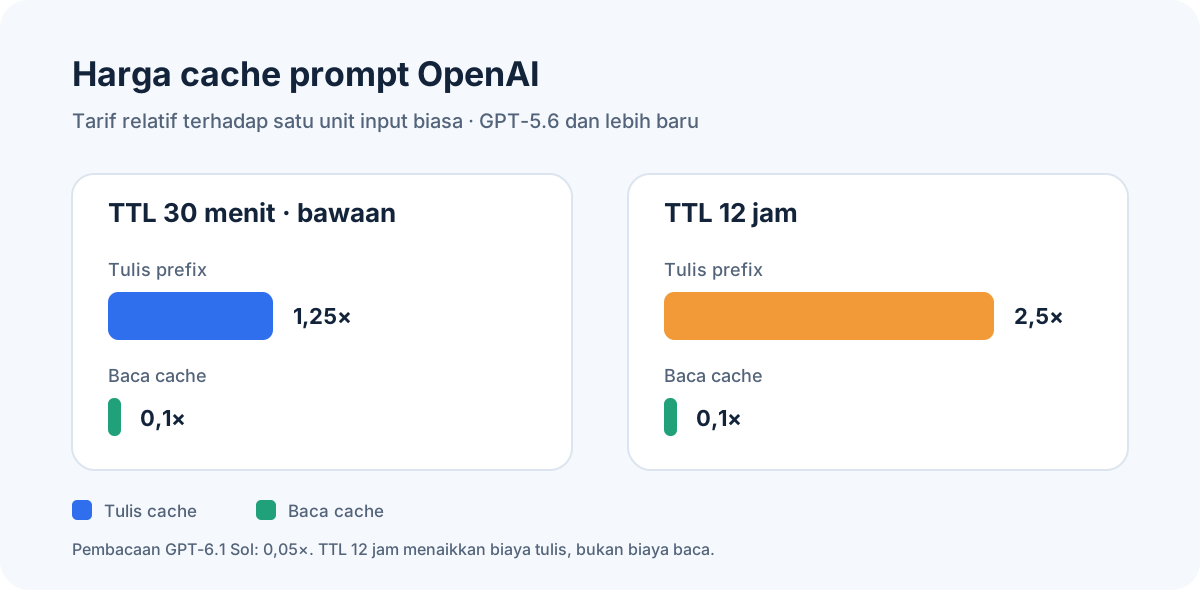
Tarif relatif terhadap input biasa pada GPT-5.6 dan model lebih baru. Tarif baca GPT-6.1 Sol adalah 0,05x. Sumber: panduan prompt caching OpenAI.
Sedikit hitungan membantu melihat kapan opsi ini masuk akal. Anggap satu prefix yang sama dipakai dalam 10 request dan sembilan request terakhir berhasil membaca cache. Opsi 12 jam menagih 2,5 unit untuk penulisan, lalu 0,1 unit untuk tiap pembacaan: total 3,4 unit, dibanding 10 unit jika prefix diproses ulang tanpa cache. Ini hanya hitungan untuk bagian prefix yang sama, bukan seluruh isi prompt atau biaya output.
Kalau semua request datang dalam rentang 30 menit dan semuanya mendapat cache hit, opsi bawaan lebih murah: satu penulisan 1,25 unit ditambah sembilan pembacaan menjadi 2,15 unit. Opsi 12 jam lebih menarik saat agent kembali setelah jeda lebih panjang. 30m menjamin kelayakan tarif baca sekurangnya 30 menit; 12h memperpanjangnya menjadi sekurangnya 12 jam.
Opsi ini cocok untuk konteks yang jarang berubah
TTL dapat dipilih lewat prompt_cache_options.ttl pada Responses API:
{
  "prompt_cache_options": {
    "ttl": "12h"
  }
}
Nilai ini tersedia untuk GPT-5.6 dan model sesudahnya. Simpan instruksi dan daftar tool yang stabil di awal prompt; letakkan pertanyaan terbaru atau konteks yang berubah setelah prefix itu. Prefix tetap harus cocok agar cache bisa dipakai. Karena itu, 12 jam lebih relevan untuk agent terjadwal atau layanan yang memakai instruksi panjang berulang, bukan untuk semua jenis request.
Di forum developer OpenAI, fitur API ini diumumkan sebagai hari ke-16 dari rangkaian pembaruan kualitas hidup. OpenAI mengaitkannya dengan agent persisten yang memakai konteks berulang sepanjang hari. Daftar pengumuman yang sama juga menyebut cache 12 jam telah aktif di Codex dan ChatGPT Work.
Masa minimum itu mengatur kelayakan tarif baca untuk prefix yang cocok. Setiap request tetap bisa saja tidak mendapat cache hit, dan 12h bukan batas waktu penghapusan: OpenAI dapat menyimpan cache lebih lama sesuai kebijakan retensi maksimum organisasi. Pantau cache_write_tokens dan cached_tokens di respons API. Kalau request jarang memakai ulang prefix yang sama, tarif tulis lebih tinggi itu bisa lebih besar daripada penghematannya.
Anda akan diarahkan ke sumber asli artikel ini.


