Peta Mercor Menunjukkan Banyak Pekerjaan Belum Terwakili Benchmark AI
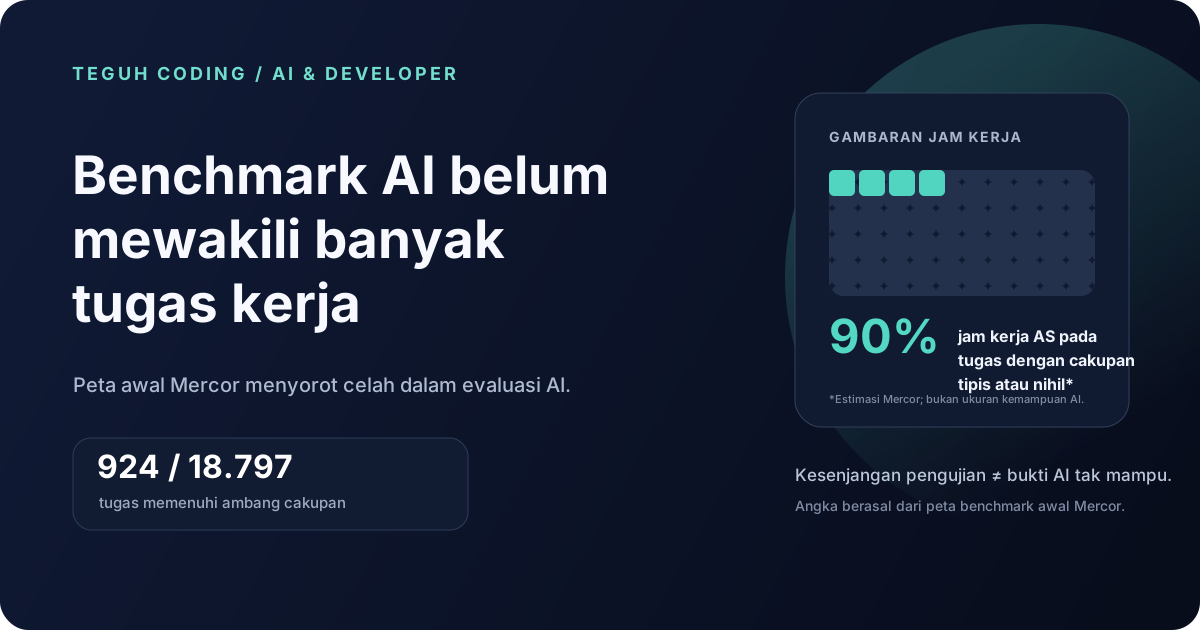
Mercor memetakan 29 benchmark AI agentik ke dalam katalog tugas kerja O*NET di Amerika Serikat. Dari 18.797 tugas yang mereka teliti, 924 memenuhi ambang cakupan yang ditetapkan. Perusahaan itu memperkirakan 90% jam kerja di AS jatuh pada tugas yang hanya sedikit atau sama sekali belum diwakili benchmark, menurut peta yang diterbitkan Mercor. Temuan ini ramai dibahas di Hacker News, tetapi berbicara tentang apa yang belum diuji dengan baik—bukan bukti bahwa AI tak mampu mengerjakan tugas tersebut atau bahwa pekerjaan itu pasti aman dari otomatisasi.
Apa yang dihitung dalam peta ini?
Mercor mencocokkan 29 benchmark agentik dengan 18.797 tugas dalam katalog O*NET, yang mencakup 923 pekerjaan dan 22 kelompok pekerjaan. Sebuah tugas baru dihitung “tercakup” bila setidaknya lima prompt benchmark dipetakan kepadanya. Dengan ambang itu, 208 dari 923 pekerjaan punya setidaknya satu tugas yang tercakup; enam dari 22 kelompok pekerjaan tidak punya pekerjaan yang mencapai ambang tersebut.
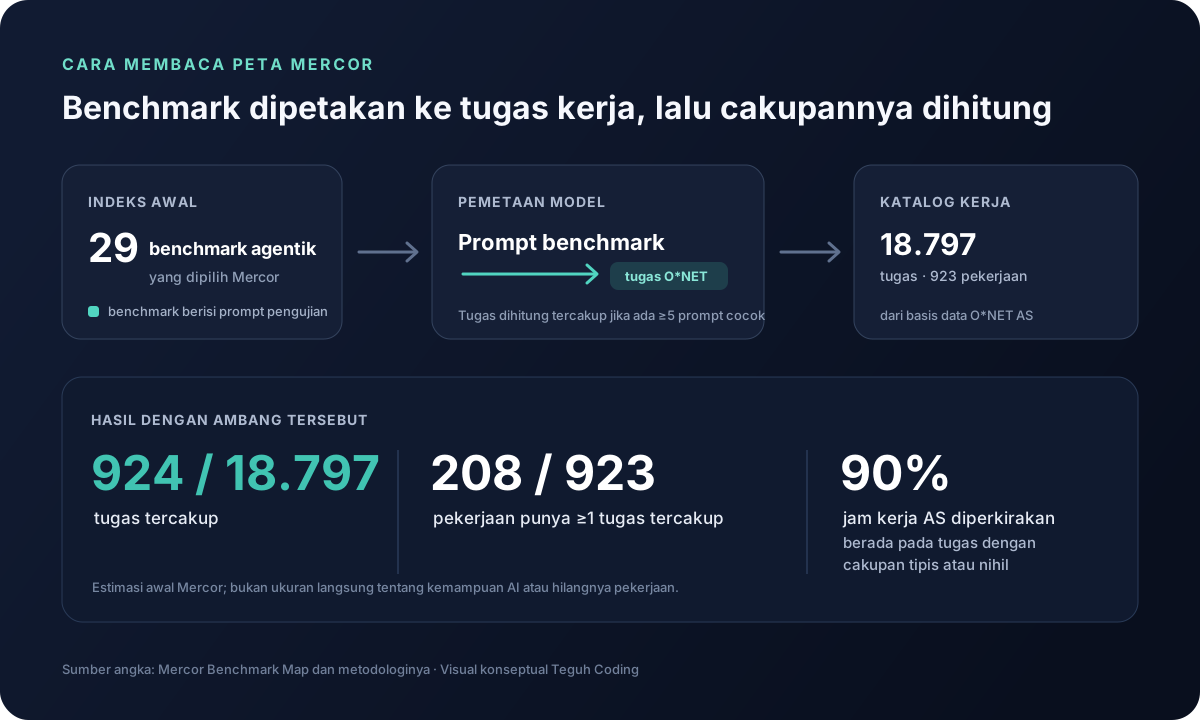
Infografik berdasarkan angka dan definisi pada peta Mercor; visual ini bukan tangkapan layar produk.
Angka 90% adalah perkiraan jam kerja pada tugas yang tidak banyak diuji dalam indeks benchmark awal Mercor. Angka itu bukan skor kemampuan model, bukan persentase tugas yang gagal dikerjakan AI, dan bukan perkiraan jumlah pekerjaan yang akan digantikan. Peta ini membantu menjawab pertanyaan yang lebih sempit: seberapa banyak tugas kerja yang saat ini terwakili oleh benchmark yang mereka pilih?
Bagaimana benchmark dipetakan?
Mercor menggunakan model bahasa untuk mengaitkan prompt benchmark dengan satu atau beberapa tugas O*NET. Untuk memperkirakan porsi jam kerja, tim menggabungkan hasil pemetaan tersebut dengan estimasi berapa banyak waktu yang dihabiskan pekerja pada tiap tugas, berdasarkan riset sebelumnya yang juga menggunakan model bahasa. Daftar benchmark dipilih berdasarkan ketersediaan publik, tugas agentik, relevansi ekonomi, keragaman pekerjaan, dan tingkat kesulitan yang belum jenuh. Rincian pemetaan dan pemeriksaan pakar tersedia di halaman metodologi Mercor.
Tim meminta pakar di platform Mercor meninjau pemetaan pada tiga benchmark APEX milik perusahaan: APEX-1, APEX-Agents, dan APEX-Accounting. Pakar menerima pemetaan utama model sebagai pilihan yang masuk akal dalam 76,7% penilaian; bila jawaban pakar muncul di mana saja dalam daftar kandidat model, angkanya menjadi 85,4%. Pemeriksaan ini hanya mencakup sebagian benchmark dalam indeks. APEX-SWE dipetakan setelah proses tinjauan itu dan tidak memiliki penilaian pakar.
Mercor juga menyebut bahwa daftar 29 benchmark tersebut belum lengkap atau sepenuhnya mewakili seluruh benchmark agentik yang tersedia. Perusahaan memperingatkan bahwa pemilihan awal ini membuat estimasi cakupan cenderung lebih rendah. Implikasinya, sebagian jam kerja yang dihitung kurang terwakili mungkin sebenarnya memiliki pengujian pada benchmark yang belum masuk indeks—ini inferensi dari batasan yang Mercor jelaskan, bukan angka yang mereka ukur. Kriteria seperti “relevansi ekonomi” juga mengandung penilaian subjektif. Jadi, angka 90% sebaiknya dibaca sebagai perkiraan dari peta awal, bukan pengukuran final yang berlaku untuk semua benchmark dan pekerjaan.
Kenapa ini relevan bagi developer?
Peta Mercor menunjukkan bahwa benchmark publik cenderung menumpuk pada tugas yang mudah diubah menjadi pengujian, termasuk rekayasa perangkat lunak dan analisis keuangan. Tugas yang dinilai lebih terpapar AI sekitar enam kali lebih mungkin muncul dalam benchmark daripada tugas yang dinilai kurang terpapar; tugas yang lebih penting dalam suatu pekerjaan juga sekitar enam hingga sepuluh kali lebih mungkin terwakili dibanding tugas yang kurang penting.
Bagi tim produk, skor benchmark tetap berguna untuk membandingkan model pada jenis pengujian yang sama. Namun, skor itu tidak otomatis menjawab apakah model cocok untuk alur kerja perusahaan sendiri. Sebelum memutuskan model atau agen mana yang akan dipakai, developer dapat menyusun evaluasi dari tugas nyata mereka—termasuk kasus gagal, waktu pemeriksaan manusia, biaya, dan konsistensi hasil—lalu mengulanginya setiap kali model atau prompt berubah.
Karena Mercor juga menerbitkan benchmark APEX yang masuk ke indeks ini, peta tersebut merupakan riset dari pelaku industri, bukan audit independen. Keterbukaan metode dan batasan yang dicantumkan membantu pembaca menilai hasilnya, tetapi pemetaan dan estimasi itu tetap perlu diuji ulang seiring indeks diperluas.
Poin utamanya bukan bahwa benchmark tidak berguna. Peta ini mengingatkan bahwa skor yang tinggi hanya menjelaskan kinerja pada hal-hal yang benar-benar diuji. Untuk keputusan tentang pekerjaan nyata, cakupan tes dan relevansi tugas sama pentingnya dengan angka di leaderboard.
Anda akan diarahkan ke sumber asli artikel ini.