Reflection Buka Bobot Beam 1.0, Dukungan llama.cpp Sudah Masuk
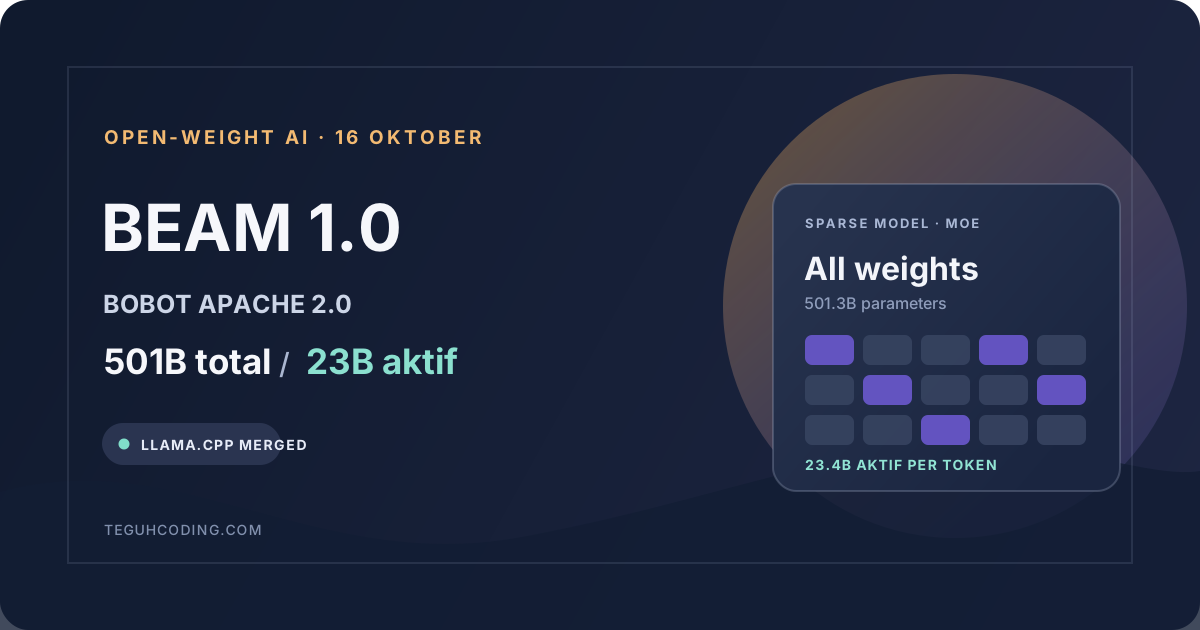
Reflection AI merilis bobot Beam 1.0 ke publik pada 16 Oktober dengan lisensi Apache 2.0. Model yang sebelumnya hanya tersedia lewat pratinjau terbatas ini kini bisa diunduh dalam format BF16, FP8, dan NVFP4. Pada hari yang sama, dukungan Beam juga digabung ke master proyek llama.cpp—kabar penting bagi developer yang ingin menjalankannya di infrastruktur sendiri. Namun, angka 23 miliar parameter aktif bukan berarti Beam hanya sebesar model 23B biasa: checkpoint penuh berisi 501,3 miliar parameter.
Dari pratinjau terbatas menjadi bobot yang bisa diunduh
Reflection pertama kali memperkenalkan Beam pada 5 Oktober, lalu membuka aksesnya secara lebih luas melalui rilis bobot pada 16 Oktober. Model card di Hugging Face mencatat lisensi Apache 2.0 dan tiga format bobot: BF16, FP8, serta NVFP4. Reflection memosisikan Beam untuk coding, reasoning, dan pekerjaan agent jangka panjang. Model ini menerima dan menghasilkan teks, serta diklaim mendukung konteks hingga satu juta token.
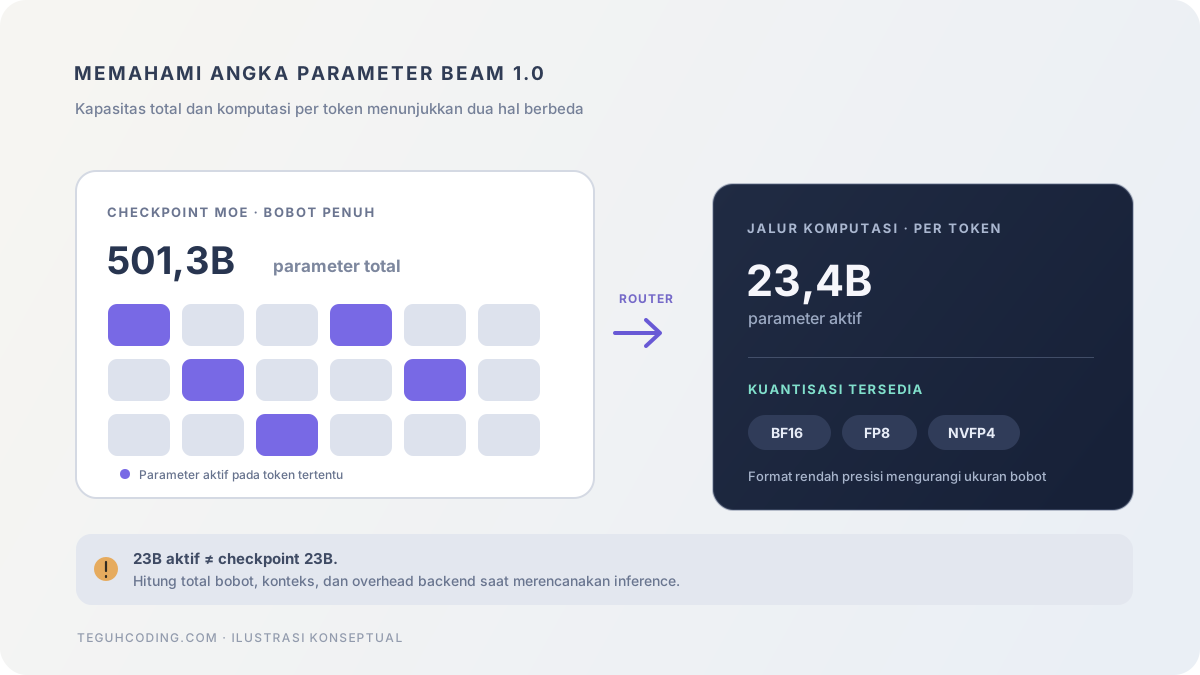
Skema konseptual, bukan diagram arsitektur internal Beam. Spesifikasi model merujuk pada model card Reflection.
Lisensi dan bobot terbuka memberi tim pilihan untuk mengunduh, menguji, dan meng-host model tanpa menjadikan API Reflection satu-satunya jalur. Reflection juga mengumumkan integrasi dengan berbagai alat serving dan agent; SiliconANGLE melaporkan bahwa paket rilis mencakup konfigurasi siap pakai untuk beberapa serving engine, resep fine-tuning, serta alat evaluasi.
Dukungan llama.cpp sudah digabung
Salah satu perkembangan komunitas yang konkret muncul pada hari rilis. Pull request “model: add Beam (Reflection)” di llama.cpp berstatus merged pada 16 Oktober. Perubahannya menambahkan converter, model graph, dan parser format tool-call Beam. Catatan pull request menyebut bobot asli dapat dikonversi, sedangkan GGUF hasil kuantisasi dapat dimuat dan menghasilkan teks di CUDA.
Integrasi ini memperluas pilihan selain layanan terkelola. Developer dapat menguji Beam melalui server lokal berbasis llama.cpp, sementara Reflection juga menyebut dukungan untuk Transformers, vLLM, SGLang, Unsloth, dan Axolotl. Status “merged” di master belum otomatis berarti semua versi stabil dan paket siap pakai sudah membawa dukungan yang sama; periksa versi backend sebelum menyiapkan deployment.
23B aktif bukan berarti ringan dijalankan
Beam memakai arsitektur sparse Mixture-of-Experts (MoE). Sekitar 23,4 miliar parameter aktif dipakai untuk memproses satu token, tetapi file modelnya tetap berisi seluruh kumpulan bobot hingga 501,3 miliar parameter. Jadi, angka aktif lebih menjelaskan banyaknya parameter yang terlibat dalam komputasi per token, bukan ukuran checkpoint yang harus disimpan dan disiapkan untuk inference.
Panduan deployment vLLM untuk Beam menunjukkan skala kebutuhannya. Angka berikut adalah estimasi dalam panduan tersebut untuk total memori GPU yang direkomendasikan konfigurasi, bukan kebutuhan universal bagi semua backend:
| Format | Ukuran bobot | Memori GPU minimum menurut panduan vLLM |
|---|---|---|
| NVFP4 | 294 GB | 353 GB |
| FP8 | 503 GB | 604 GB |
| BF16 | 1.003 GB | 1.204 GB |
Untuk konfigurasi NVFP4, panduan itu merekomendasikan empat GPU B200/B300 atau satu tray GB200/GB300; konfigurasi delapan H100 juga tersedia dengan backend tertentu. Angka minimum vLLM mencakup bobot dan cadangan untuk aktivasi, CUDA graphs, serta KV cache. Kuantisasi mengurangi ukuran dibanding BF16, tetapi tidak membuat Beam setara dengan model 23B yang bisa langsung dijalankan di GPU konsumen.
Pertanyaan itu juga muncul dalam diskusi r/LocalLLaMA saat bobot Beam dirilis: apakah label A23B berarti model dapat berjalan dengan VRAM 8–16 GB? Angka parameter aktif saja tidak cukup untuk menjawabnya; total bobot, RAM/VRAM, backend, dan panjang konteks ikut menentukan konfigurasi yang mungkin dijalankan.
Terbuka untuk eksperimen, tetap butuh infrastruktur
Rilis ini membuat Beam lebih mudah diuji dan diintegrasikan ke tooling coding agent, termasuk lewat llama.cpp. Untuk tim yang ingin mengontrol model dan datanya sendiri, bobot Apache 2.0 menawarkan fleksibilitas dibanding akses API saja. Tetapi menjalankan checkpoint penuh tetap membutuhkan sumber daya kelas server. Tim tanpa infrastruktur tersebut masih dapat mengevaluasi model melalui API Reflection atau penyedia yang mendukungnya, lalu membandingkan hasil dan biaya sebelum memilih jalur produksi.
Anda akan diarahkan ke sumber asli artikel ini.