XERJ Bantu Coding Agent Cari Kode, tapi Klaim Hemat Token 40× Punya Syarat
XERJ muncul di GitHub Trending pada 18 Oktober dengan tawaran sederhana: indeks folder sekali, lalu biarkan coding agent mencari bagian kode yang dibutuhkan. Deskripsi repositorinya menyebut penghematan sampai 40× dibanding grep. Namun, benchmark utama proyek mencatat angka 2,7× pada jenis tugas tertentu. Hasilnya paling menjanjikan saat model belum mengenal codebase yang sedang dikerjakan.
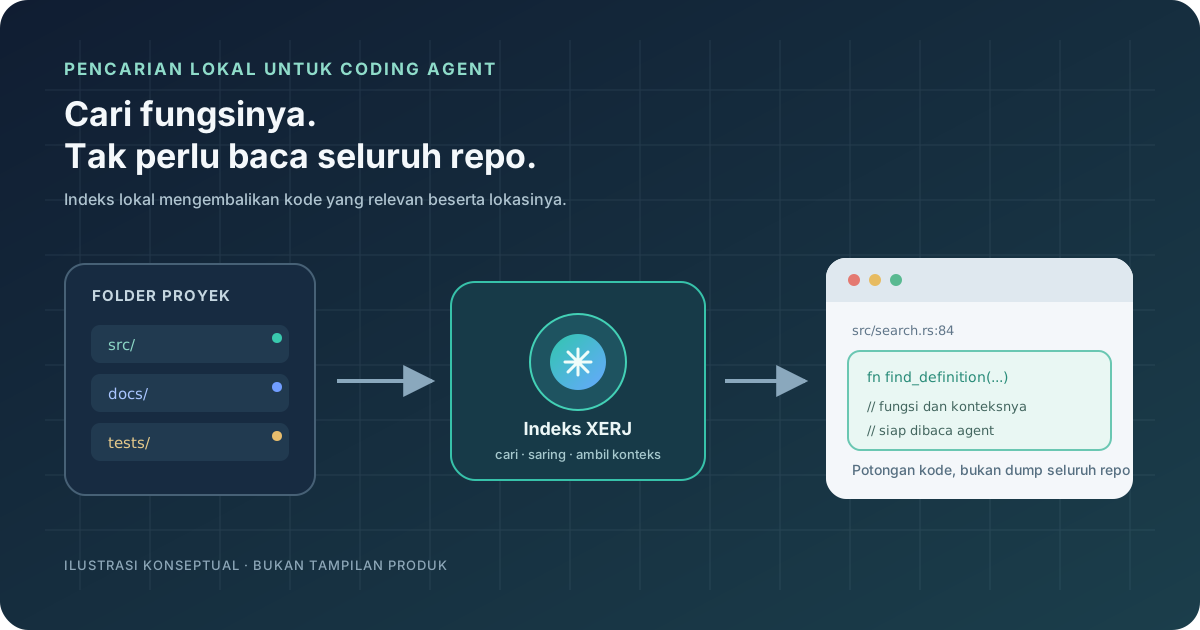
Ilustrasi konseptual Teguhcoding, bukan tangkapan layar XERJ.
Mesin pencarian untuk konteks coding agent
XERJ bukan model AI. Ini mesin pencarian lokal berbasis Rust yang membuat indeks dari kode, dokumentasi, PDF, CSV, dan sejumlah format lain. Perintah xerj autoindex ./proyek memindai folder; setelah itu, agent bisa menanyakan simbol atau fungsi dan menerima potongan beserta nama file dan nomor baris, alih-alih membuka banyak file satu per satu.
Proyek ini juga menyediakan API yang kompatibel dengan Elasticsearch dan server MCP, sehingga bisa dihubungkan ke coding agent yang mendukung MCP. Keduanya bagian dari satu binary, dan lisensi repositorinya Apache 2.0. Dokumentasi XERJ menjelaskan cara kerjanya serta batas dukungan tiap integrasi.
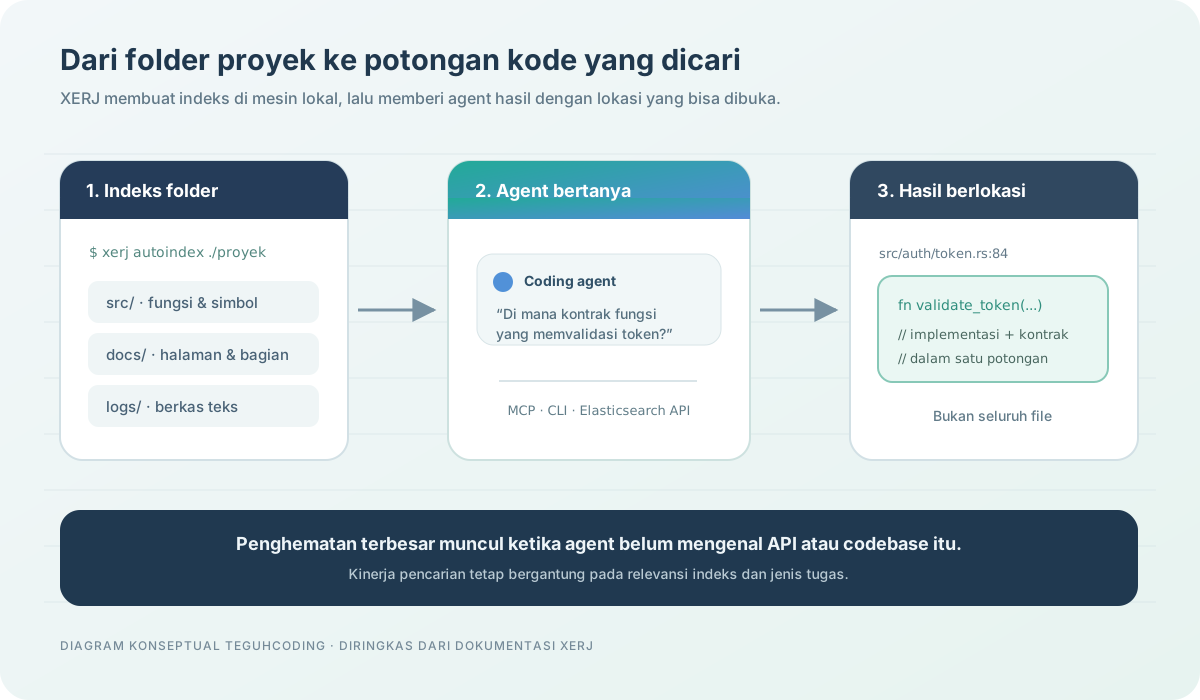
Alur diringkas dari dokumentasi proyek; bukan rancangan internal mesin pencari.
Angka 40× bukan hasil umum benchmark utama
Angka di deskripsi repo mudah dibaca sebagai hasil yang akan didapat semua orang. Benchmark utama XERJ lebih spesifik: pada delapan tugas lintas Python, JavaScript, C, dan Java, pengujian membandingkan agent yang memakai memorinya sendiri, grep, atau hasil pencarian XERJ. Dengan XERJ, jumlah output token tercatat 9.982, dibanding 26.477 untuk pendekatan grep—sekitar 2,7× lebih sedikit. Kedua pendekatan menyelesaikan 16 dari 16 percobaan.
Tes tersebut memakai API dan pustaka yang sengaja tidak familier bagi model. Di situlah indeks paling berguna: agent bisa mengambil kontrak dan contoh dari kode yang sebelumnya belum pernah dilihatnya. Di pustaka publik yang sudah dikenal model, hasilnya berubah. Data XERJ sendiri menunjukkan bahwa pencarian dapat menambah biaya dan tidak selalu meningkatkan keberhasilan.
Pencarian kode dan log belum sama kuat
Sebuah laporan pengguna di issue GitHub, yang dibuka pada 16 Oktober, mencatat hasil campuran saat XERJ dicoba pada proyek PBX dengan 1.104 file. Ketika pencarian menemukan fungsi yang tepat, hasilnya menyertakan lokasi kode dan membantu dibanding pencarian baris biasa. Namun, dari lima pertanyaan agent yang diuji, dua tidak menemukan file jawaban yang diharapkan dan satu hanya memberi hasil sebagian.
Pengguna yang sama juga melaporkan bahwa pencarian log belum cocok untuk troubleshooting: hasilnya tidak mempertahankan waktu, host, dan tingkat keparahan sebagai kolom yang bisa difilter. Ini satu pengujian pada satu proyek, bukan evaluasi menyeluruh, tetapi cukup untuk menunjukkan bahwa klaim dukungan banyak format tidak berarti setiap jenis pencarian sudah matang.
Versi terbaru yang ditautkan proyek saat artikel ini ditulis masih berlabel release candidate (v1.0.0-rc.96). Untuk percobaan lokal, perhatikan pula konfigurasi --insecure: dokumentasi menyebut opsi itu mematikan TLS dan autentikasi API. Instance baru dibatasi ke 127.0.0.1, jadi jangan membuka port tersebut ke jaringan tanpa mengatur autentikasi dan membaca model keamanan XERJ. Fitur reranking Jev yang opsional juga mengirim kueri dan teks hasil pencarian ke layanan eksternal jika diaktifkan; detailnya ada di dokumentasi reranking.
XERJ layak dicoba pada codebase privat atau API internal yang belum dikenal model—tempat jawaban berdasarkan tebakan dan pembacaan file berulang memang mahal. Untuk repositori populer, atau pencarian log produksi, ukur dulu apakah hasilnya lebih tepat dan apakah penghematan tokennya menutup biaya indeks serta pemakaian memorinya.
Anda akan diarahkan ke sumber asli artikel ini.